Domain cdqa.de kaufen?
Wir ziehen mit dem Projekt
cdqa.de um.
Sind Sie am Kauf der Domain
cdqa.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain cdqa.de kaufen?
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **

Ähnliche Suchbegriffe für Textklassifizierung
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
Busch-Jaeger Steck-Glimmlampe 0,4mA - 8350 Universalbeleuchtung/OrientierungBusch-Jaeger Steck-Glimmlampe 0,4mA - 8350 Passend für UP-Einsätze 2000/..., 2020/..., 2025Für Schalter/Taster - ohne Serienschalter.UniversalbeleuchtungNennspannung: 230 V, 0,4mA Auswechselbare Steck-Glimmlampe.4,38 €*Versand: 6,90 €Sichere Weiterleitung zum Anbieter
-
LogiLink DisplayPort Tester für EDID InformationDer DisplayPort Tester von LogiLink ermöglicht ein schnelles und einfach Auslesen der im Monitor gespeicherten EDID Daten. Angezeigt werden Auflösung, HDCP Version, Farbraum und das Ergebnis des Link Training.23,69 €*Versand: 3,90 €Sichere Weiterleitung zum Anbieter


-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **


Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
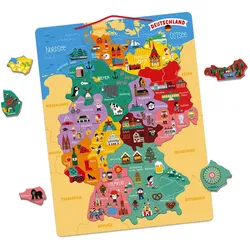
JANOD Magnetische Deutschlandkarte – Fördert geografisches Wissen u. Orientierung von 7 bis 10 JahrenMit der magnetischen Deutschlandkarte von JANOD wird die Geografie zu einem spannenden Abenteuer für Kinder von 7 bis 10 Jahren. Spielerisch lassen sich die Bundesländer und ihre Besonderheiten entdecken und die eigene Heimat besser kennenlernen. mit 79 detailreichen Magneten, die Bundesländer, Spezialitäten und Sehenswürdigkeiten zeigen fördert das geografische Wissen und die visuelle Orientierung farbliche Gestaltung zur einfachen Unterscheidung der Regionen kann als dekoratives Lernobjekt im Kinderzimmer aufgehängt werden gefertigt aus nachhaltig produziertem Sperrholz und Holzfaser Jedes der 79 Puzzleteile findet seinen Platz auf der großen Holzkarte und stellt ein Bundesland, eine typische Spezialität, ein bekanntes Bauwerk oder eine geografische Besonderheit dar. Durch die liebevollen Illustrationen und die farbliche Abgrenzung der einzelnen Regionen fällt die Zuordnung leicht. So prägen sich Kinder die Lage der Bundesländer, ihrer Hauptstädte sowie bekannter Wahrzeichen ganz von selbst ein. Die Karte kann einfach an der Wand befestigt werden und wird so zu einem lehrreichen Blickfang. Mit den Maßen von 30 x 1 x 40 cm hat sie eine angenehme Größe zum Spielen und Betrachten.22,99 €*Versand: 3,95 €Sichere Weiterleitung zum Anbieter
-
Antwort-Buzzer Kinderturnen Unisex**Die Learning Resources Antwort-Buzzer für Unterricht, Spaß und Spiel** Die Antwort-Buzzer von Learning Resources sind ideal, wenn Sie Ihren Unterricht auflockern möchten oder um Kindern die Angst bei mündlichen Prüfungen zu nehmen. Durch die Interaktion werden die Kinder zusätzlich motiviert. Die Buzzer können Sie natürlich auch bei Frage- und Antwortspielen einsetzen. Je Buzzer benötigen Sie 2 Batterien AAA, die nicht im Lieferumfang enthalten sind. **Produktdetails** Material: Kunststoff Maße: ø 9 cm Benötigt 2AAA Batterien, nicht enthalten **Mit Licht und Ton** Farben und Signalton: Grün (Laser), Orange (Summen), Rot (Alarmsirene), Blau (Fanfare) Transparente Buzzerfläche, leuchtet und gibt Signalton bei Druck Spielart: Konzentrationsspiele, Gesellschaftsspiele Spieltyp: Buzzerspiel43,48 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Busch-Jaeger Steck-Glimmlampe 0,4mA - 8350 Universalbeleuchtung/OrientierungBusch-Jaeger Steck-Glimmlampe 0,4mA - 8350 Passend für UP-Einsätze 2000/..., 2020/..., 2025Für Schalter/Taster - ohne Serienschalter.UniversalbeleuchtungNennspannung: 230 V, 0,4mA Auswechselbare Steck-Glimmlampe.4,38 €*Versand: 6,90 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
-
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **
-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
Ähnliche Suchbegriffe für Textklassifizierung
-
LogiLink DisplayPort Tester für EDID InformationDer DisplayPort Tester von LogiLink ermöglicht ein schnelles und einfach Auslesen der im Monitor gespeicherten EDID Daten. Angezeigt werden Auflösung, HDCP Version, Farbraum und das Ergebnis des Link Training.23,69 €*Versand: 3,90 €Sichere Weiterleitung zum Anbieter
-
Azure Information Protection Premium P1 (NCE)Azure Information Protection Premium P1 (NCE): Produktbeschreibung und Systemanforderungen Azure Information Protection Premium P1 (NCE): Produktbeschreibung und Systemanforderungen Über Azure Information Protection Premium P1 (NCE) Azure Information Protection Premium P1 (NCE) ist ein cloudbasierter Dienst von Microsoft, der Unternehmen dabei unterstützt, sensible Informationen zu klassifizieren, zu schützen und zu überwachen. Durch die Kombination von automatisierter Klassifizierung, Verschlüsselung, Rechteverwaltung und Überwachung bietet Azure Information Protection Premium P1 eine umfassende Lösung zum Schutz vertraulicher Daten in der Cloud und vor Ort. Hauptmerkmale von Azure Information Protection Premium P1 (NCE) Klassifizierung von Informationen: Automatisierte Klassifizierung von Dokumenten und E-Mails basierend auf vordefinierten Richtlinien und Benutzerdefinierter Inhalts...23,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
-
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
-
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.